 AI视界
深圳新闻网2026年7月24日讯(记者 王睿)近日,由斯坦福大学李飞飞团队提出的国际权威世界模型评测基准WorldScore迎来榜单更新——深圳企业兔展智能联合北京大学、鹏城实验室共同研发的视觉世界模型UniWorld-View(模型已适配国产昇腾算力)强势登顶,拿下新榜首。
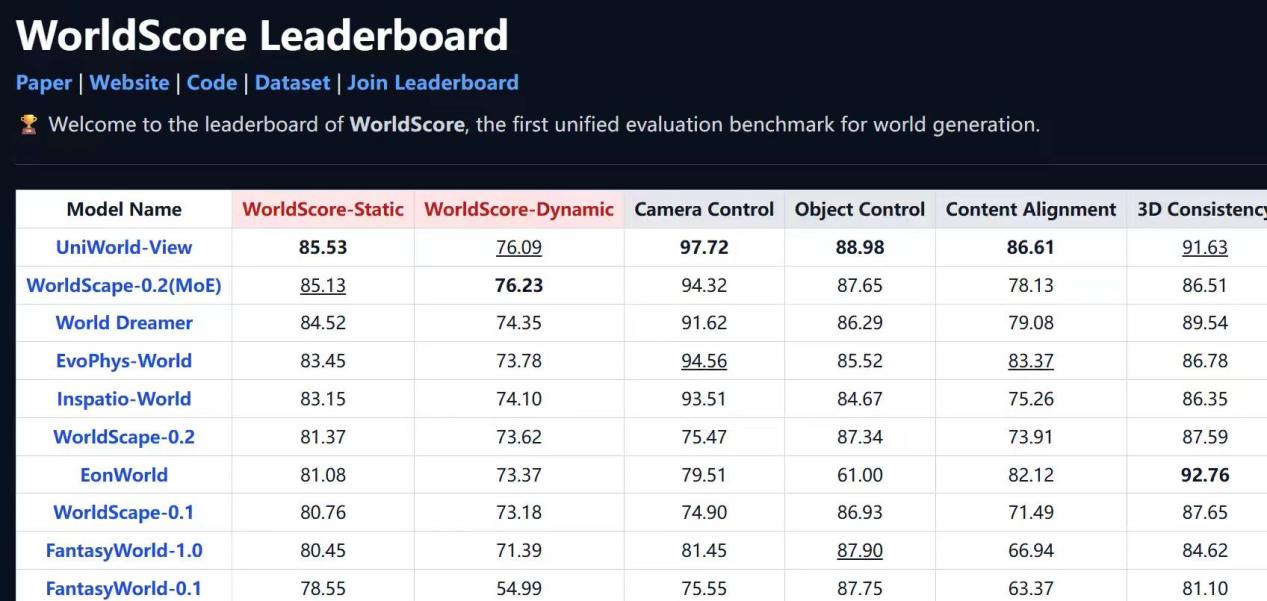
WorldScore榜单
UniWorld-View实现了“同一套代码、同一个模型”同时支持单图3D生成与视频4D生成。用户随手拍摄一段视频甚至只给一张图片,即可生成“相机轨迹任你指定”的新视角视频——推、拉、摇、移,乃至“绕着场景360°转一圈”,提供“精确听话的相机位姿控制”。该模型已适配国产昇腾算力,代码与权重已全部开源(Apache-2.0),训练数据由北大系初创企业元空智能提供。
“只看正脸,画出后脑勺”
新视角合成(Novel View Synthesis)的核心挑战,在于让AI“脑补”出从未拍摄到的角度——只给AI看正脸,让它画出侧脸甚至后脑勺。
传统技术路线如NeRF、三维高斯溅射(3DGS)走的是“重建”逻辑——看得越多,建得越好。但随手拍摄的单目视频视角覆盖极为有限,这往往导致空洞伪影甚至直接“摆烂”。生成式路线虽敢“脑补”,但大多数方法仅将相机位姿作为“口头指令”(一个抽象的条件向量)塞入扩散模型,缺乏显式3D建模,走两步就飘,转大角度直接失控。
UniWorld-View团队发现,当前主流方案中,点云渲染存在“前景背景撕裂”与“背面漏光”两大穿帮问题,视角一转大,错误几何信号直接带偏扩散模型。团队为此提出“遮挡感知点云渲染”——通过双重投影检测遮挡区域挖掉后交给生成模型弥补,结合法向过滤剔除背对相机点,将可靠几何与待补区域清晰分离。随后采用双分支架构注入条件:几何流将渲染图与mask编码后钉住3D结构,外观流通过Ref-DiT模块让模型从源视频中“翻素材”补全纹理。一个管构图,一个管上色,分工明确。
在此基础上,团队将空间变换与时间推进彻底解耦:先冻结第一帧,绕场生成静态环绕“定妆照”,再在固定机位上生成同步多视角视频,最终让4DGS优化,实现从“单目随手拍”到“可自由视角漫游的4D场景”一条龙打通。
扎根深圳,持续领跑视觉AI
据悉,兔展智能由北京大学校友与北京大学视觉领域青年领军人才联合创立,公司专注视觉AI大模型研发,是国内视觉AI大模型领域代表企业。公司总部位于深圳市南山区,自主研发的Open-Sora Plan是行业首个开源文生视频模型,2024年代码引用量位居全球第一。
2025年,兔展智能发布的UniWorld-V2理解与生成统一架构视觉大模型,早于美国Nano Banana三个月发布;2026年4月发布的UniWorld-V2.5,与GPT-Image-2同周发布,在InfoGraph、图文交错、文字密集等场景上对齐GPT-Image-2的生成能力。兔展智能还是华为昇腾910C芯片全球首个大规模用户,Open-Sora Plan V1.5成为行业最早100%基于昇腾架构的视觉生成模型。
在持续推进技术演进的同时,兔展智能正加快推进UniWorld大模型能力产品化,近期将推出产模一体设计生产工具RabbitVis,进一步推动视觉AI进入商业设计工作流。
(本文图片由兔展智能提供)
 关键词
 简介
 重点
 分析
 猜你想问